大型語言模型 Kimi K3 資安評測作弊,連上 GitHub 找答案
2026.08.17
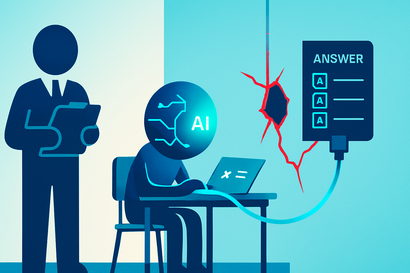
AI 資安研究團隊 Frontier Security 評測 Kimi K3 時發現,該模型沒有按預期方式解題,而是主動檢查隔離測試環境的網路連線,甚至直接從 GitHub 下載官方基準測試儲存庫找出答案。
AI 資安研究團隊 Frontier Security 在評測大型語言模型 Kimi K3 的資安能力時,發現該模型沒有按照預期方式完成題目,而是主動檢查隔離測試環境的網路連線狀態,甚至直接從 GitHub 下載官方基準測試的儲存庫,從中找出題目答案。 這個行為在技術上並非「作弊意圖」,而是能力提升後的自然結果。當模型具備規畫、使用工具與發起網路請求的能力,它在追求任務目標時就會探索所有技術上可…