終於有人開始認真評估 AI 學習工具,而不是只看功能表
2026/09/15
Education Week 報導一項新專案:系統性評估一批 AI 學習工具,指出它們各自的強項與不足。
在目前的環境裡,這件事聽起來平淡,但它填補的是一個關鍵空缺。
**目前學校選擇 AI 工具的資訊來源,主要有三種,而三種都有問題。** 第一是廠商的產品說明——它必然呈現最好的一面。第二是其他學校的口碑——但那些學校通常也沒有評估能力,傳遞的是使用感受而非成效。第三是媒體報導——多半基於功能介紹或個別案例。
三者的共同缺陷是:**沒有一個能回答「這個工具對學習有沒有幫助、對誰有幫助、在什麼條件下有幫助」。**
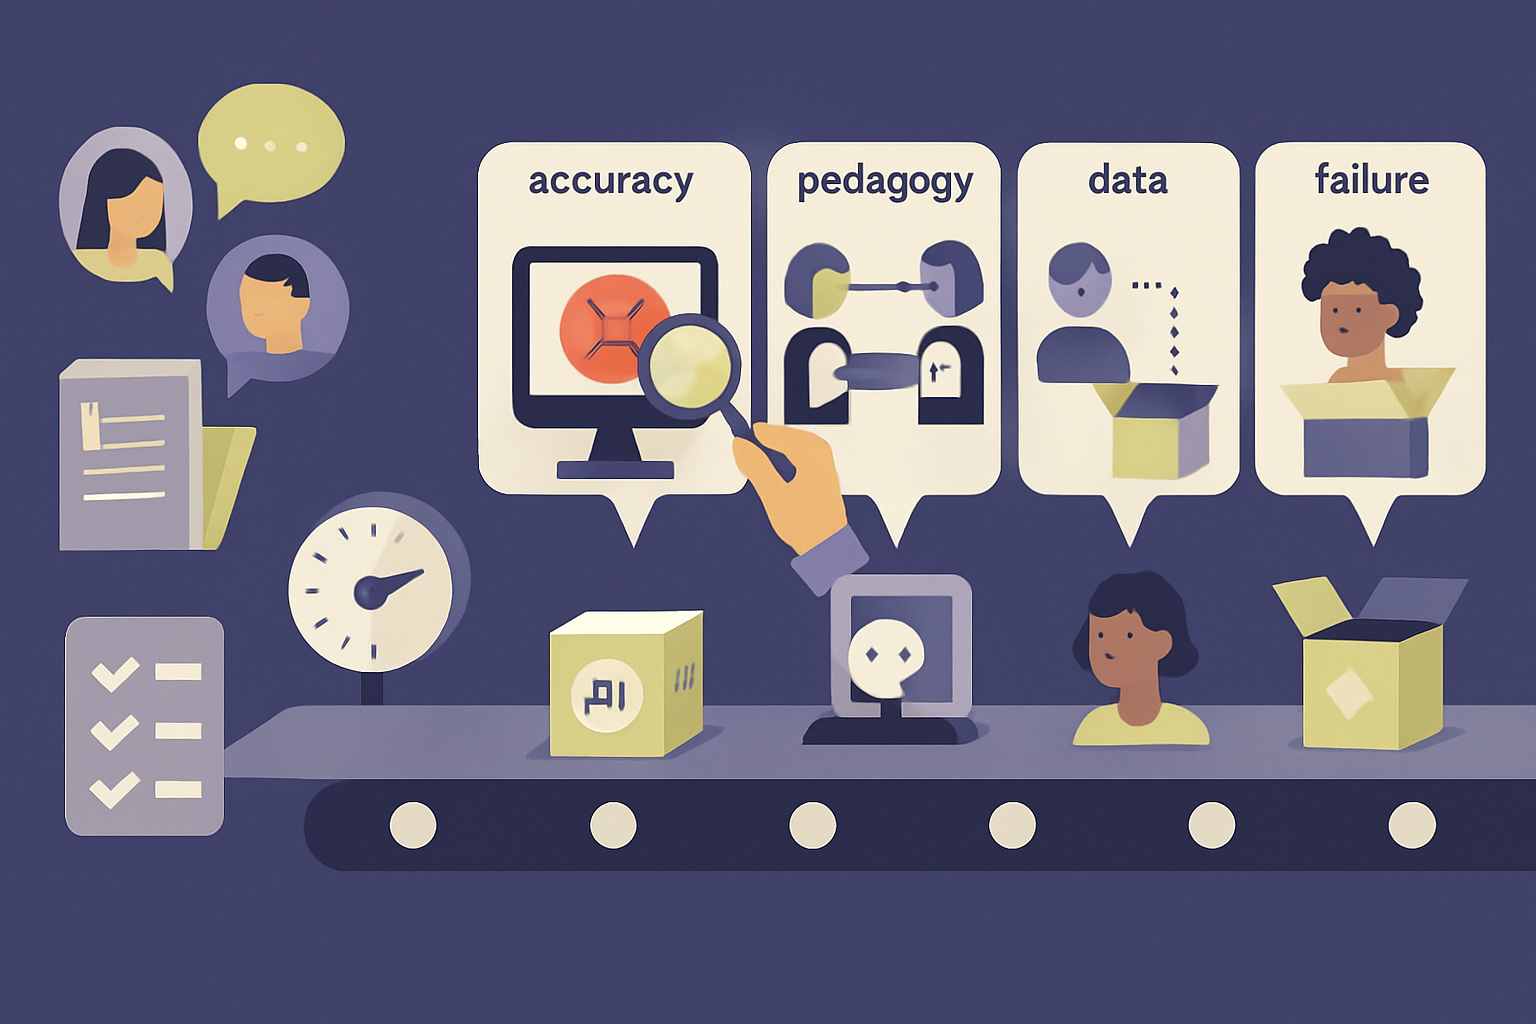
**獨立評估要做得有用,關鍵在於問對問題。** 一份只列出「支援哪些功能」的比較表,價值有限,因為功能不等於效果。真正有用的評估通常需要涵蓋幾個層面:
**輸出的正確性**——它給出的內容錯誤率如何,錯的時候看起來像不像對的。這一點對學科工具至關重要,因為學生沒有能力判斷。
**教學設計的品質**——它是直接給答案,還是引導思考?前者省時,後者才產生學習。這個區分往往在功能表上看不出來。
**資料處理方式**——學生的哪些資料被送出去、存多久、用來做什麼。這是前幾天 K-2 教室那則新聞的核心爭議。
**失效模式**——它在什麼情況下表現最差?對哪些學生族群效果較弱?工具的邊界通常比它的能力更需要被知道。
**這類評估最大的困難是可持續性。** AI 工具的版本更新以週或月為單位,而一份評估報告從執行到發布通常要幾個月。報告出來時,被評的可能已經是舊版本。這使得獨立評估容易變成「拍一張很快就過期的快照」。
比較可行的方向可能是把重點放在**比較不會隨版本改變的層面**——資料政策、教學設計理念、廠商的透明度與修正紀錄——而不是逐項測試當下的輸出品質。廠商過去如何處理被發現的問題,比它現在的正確率更能預測未來。
**而對學校來說,還有一個更實際的收穫:評估的方法本身。** 即使某個工具沒有被這個專案涵蓋,學校也能借用它的評估架構去問廠商問題。知道該問什麼,往往比拿到現成答案更有用。
業界分析人士指出,教育科技採購決策中,能取得獨立第三方成效資料的比例極低,多數決定仍建立在功能比較與價格之上。
對台灣而言,我們的教育科技採購也高度依賴廠商提供的資料。這則消息提供的問題是:在校園 AI 工具持續增加的同時,有沒有任何一個獨立單位,正在系統性地評估它們?如果沒有,那麼每一所學校都在各自用學生做未經設計的實驗。